代码仓库:https://github.com/liangdabiao/Multimodal-RAG
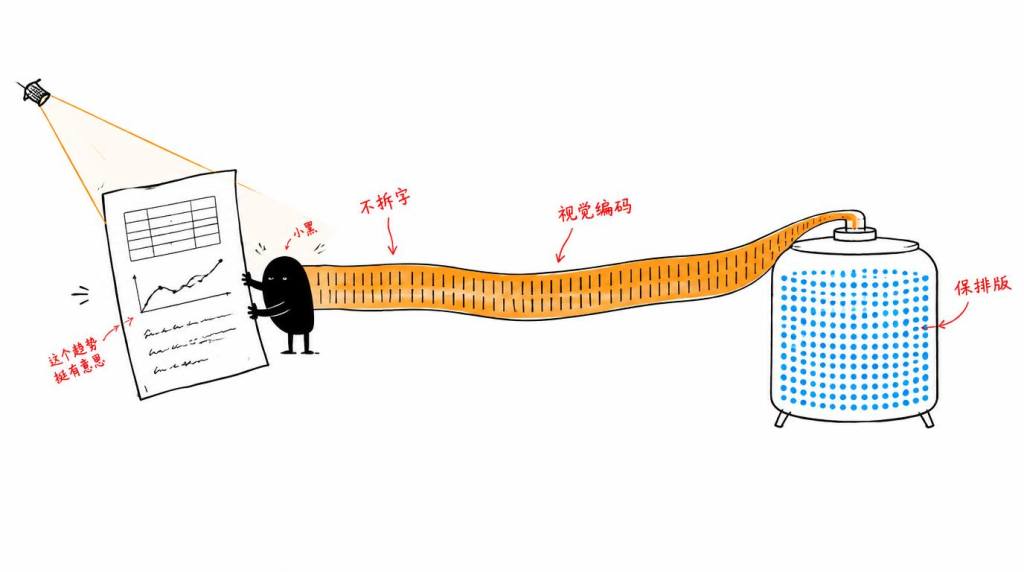
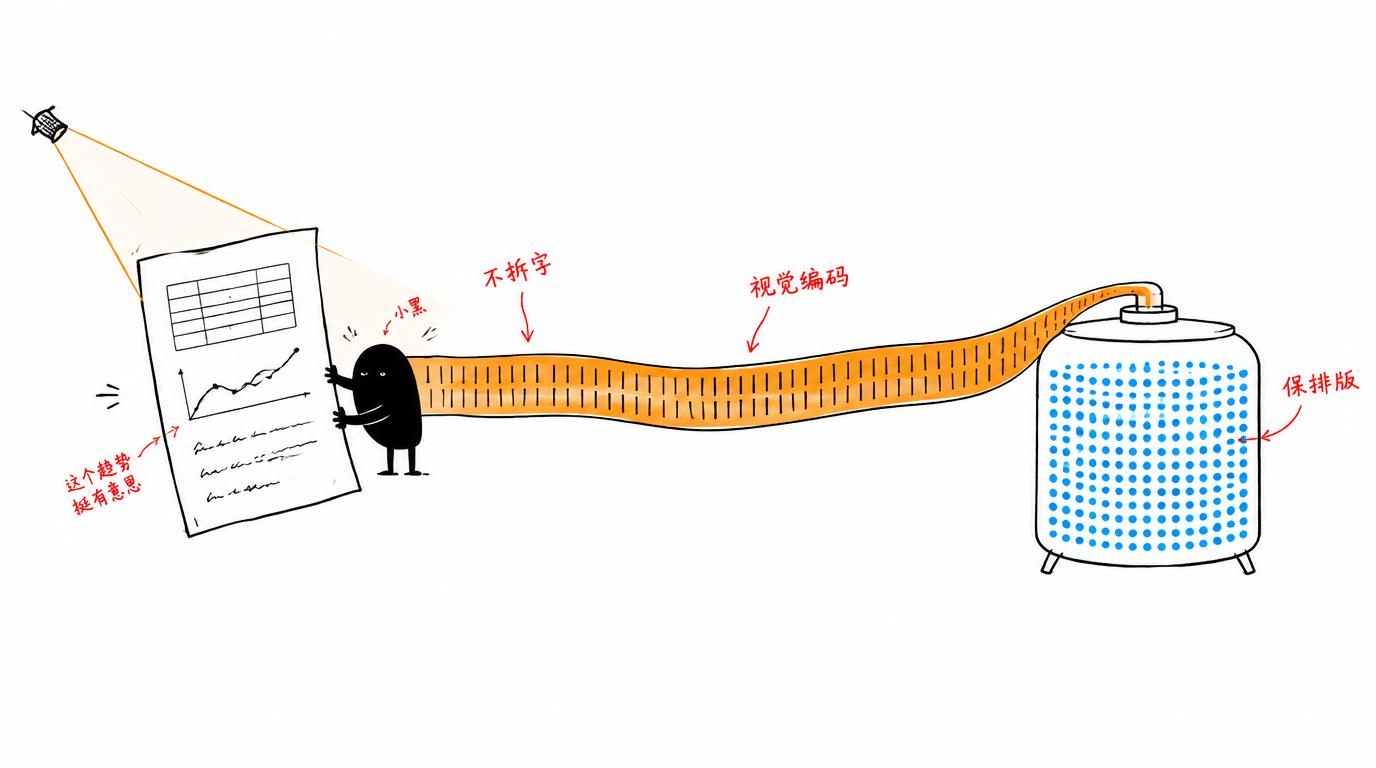
传统 RAG 要先提取文字、做 OCR,表格图表容易丢。这个多模态 RAG 直接把 PDF 每一页当成图片,用视觉 Embedding 编码,完整保留表格、图表、排版甚至手写批注,再由 Qwen 视觉模型理解回答。
它能做什么
- PDF 页面直接视觉编码,不做文本提取/OCR
- 完整保留表格、图表、排版、手写批注
- 支持 Cohere / DashScope Embedding 切换
- 支持 DashScope / OpenRouter 视觉模型切换
怎么用
上传 PDF,用自然语言提问即可得到带出处的回答。
适合谁 & 边界
处理扫描件、图表密集型文档的人。视觉方案的索引成本比纯文本略高。
仓库
https://github.com/liangdabiao/Multimodal-RAG